# Analyser des factures avec Strom
> Une approche rapide et peu coûteuse pour extraire des données structurées de factures PDF.
Shashank Aggarwal · 15 oct. 2026 · 4 min de lecture · Ingénierie
Canonical: https://platform.uprelic.com/fr/blog/analyser-des-factures-avec-strom
Deutsch: https://platform.uprelic.com/de/blog/rechnungen-mit-strom-analysieren.md
English: https://platform.uprelic.com/blog/analysing-invoices-using-strom.md
---
Certains de nos utilisateurs se servent de Strom pour mieux comprendre leurs documents :
- Classer des e-mails et des PDF par catégorie (par ex. cet e-mail est-il une résiliation d’abonnement ?)
- Extraire et vérifier des données précises dans des documents et des images (par ex. le taux de TVA appliqué est-il correct ?)
Ce problème revient assez souvent pour que nous ayons construit une chaîne d’extraction de données pour les factures. Vous pouvez l’essayer ici.
La suite de cet article explique comment fonctionne cet extracteur et montre comment utiliser Strom efficacement pour traiter des données en masse.
## En bref
Voici le déroulement complet, dans les grandes lignes :
1. L’utilisateur envoie une ou plusieurs factures PDF
2. Extraction du texte du PDF (les PDF non numériques passent d’abord par l’OCR)
3. Conversion des pages du PDF en images
4. **Envoi des images et du texte extrait à Strom**
5. Nettoyage de la réponse et contrôles logiques
## La place de Strom
L’étape intéressante ci-dessus est la requête envoyée à Strom. L’idée de base est la suivante :
> « Strom, ce PDF compte 200 lignes. Laquelle correspond à la date d’échéance de la facture ? »
Autrement dit, comme les modèles de décision ne peuvent pas générer de texte, nous reformulons la tâche en une série de questions à choix multiples.
Voici à quoi ressemble une requête type envoyée à Strom :
```json
POST https://api.uprelic.com/v1/systemone
{
"model": "strom-1.0.7",
"state": "The lines below are every text line of an invoice PDF....
L1 (page 1, x=393, y=108): INVOICE
L2 (page 1, x=85, y=138): Tobacco Merchants Association, Inc.
...
L44 (page 1, x=83, y=728): All payments to TMA are due in U.S. Dollars
",
"questions": {
"supplier": {
"type": "choice",
"criteria": {"L1": null, "L2": null, "…": null, "L45": null, "none": "No line contains it"},
"instructions": "Which line contains the name of the supplier, the company that issued the invoice?"
},
"due_date": { "…": "Which line contains the payment due date?" },
"gross_total": { "…": "Which line contains the total amount including VAT?" }
...
},
"media": [
{"type": "image", "url": "data:image/png;base64,iVBORw0KGgo…"}
]
}
```
Points à noter dans la requête :
1. La requête contient **à la fois les images des pages (dans `media`) et le texte du PDF (dans `state`)**. On pourrait objecter que les images et le texte contiennent les mêmes données en double, mais nous avons constaté que joindre les deux présente des avantages :
- **Image** : indique à Strom où se trouve le texte sur la page. Sans image, un texte comme « 200€ » n’a pas de sens. En revanche, le voir sous un tableau de lignes de facture laisse fortement penser qu’il s’agit du montant TTC. Voici ci-dessous un exemple d’image que nous montrons à Strom.
- **Texte** : en théorie, l’image devrait suffire pour que Strom nous dise, par exemple, que la ligne 5 est le montant TTC. Mais les images peuvent être en basse résolution, et le texte et les étiquettes de l’image peuvent se chevaucher.
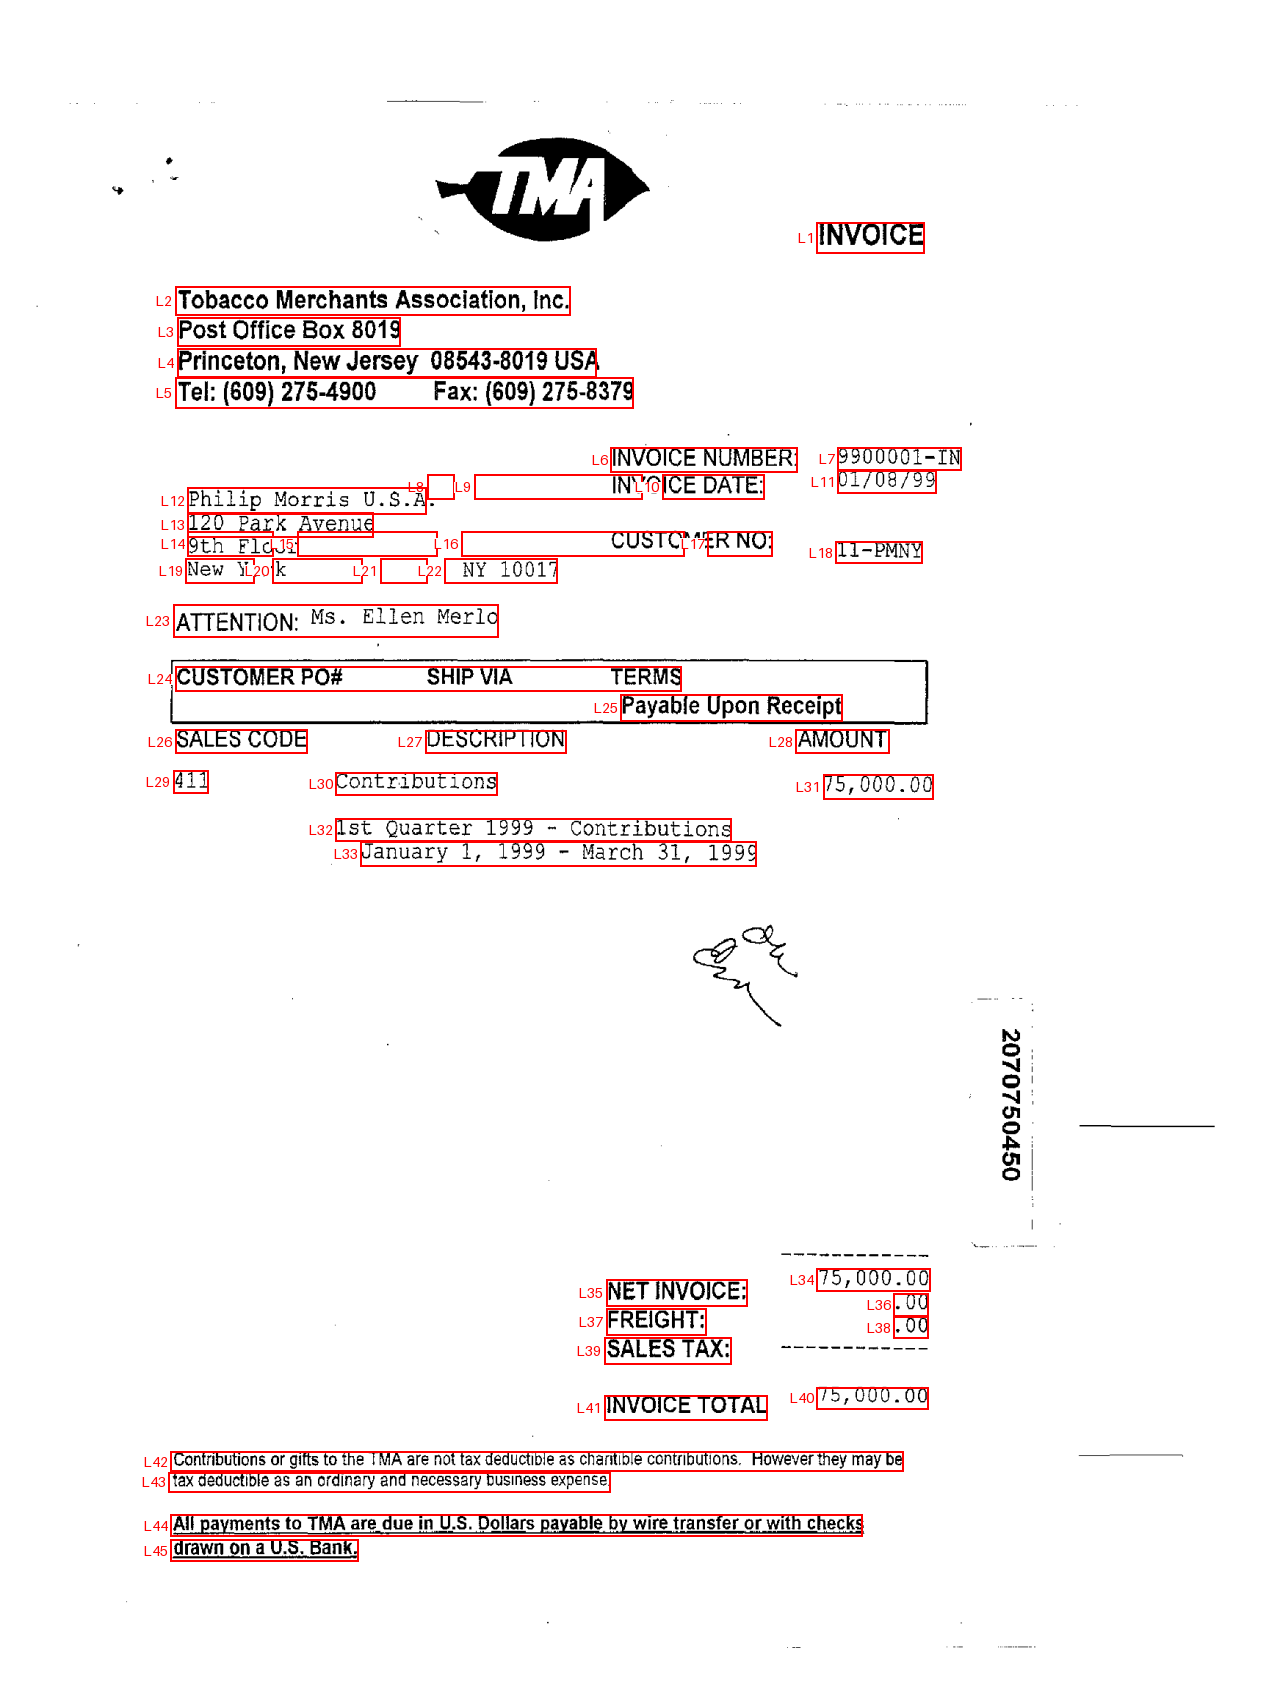
2. **Chaque champ de la facture devient une question**. Nous posons 12 questions de ce type, plus une pour la devise de la facture. Chaque question est de type « Choice », et chaque ligne du PDF est une option que Strom peut choisir. Chaque question a aussi une option « none », au cas où le champ serait absent de la facture. Le numéro de TVA peut par exemple manquer dans le PDF, et Strom doit pouvoir l’indiquer.
Voici à quoi ressemble la **réponse** :
```json
{
"model": "strom-1.0.7",
"answers": {
"supplier": {
"type": "choice",
"choice": "L2",
"confidence": 0.9677762475508005,
"probabilities": {
"L1": 0.004401314928251427,
"L2": 0.9785174983672003,
...
"L45": 9.183572895225142e-05,
"none": 0.0011083225443333591
}
},
"invoice_number": {
"type": "choice",
"choice": "L7",
...
}
},
"usage": ...
"metadata": ...
}
```
## Points forts de cette approche
- **Pas d’hallucinations** : Strom choisit la ligne qui, selon lui, correspond à la date d’échéance. Il ne peut donc pas inventer de valeurs, ce qui est un obstacle majeur avec les LLM classiques.
- **Rapidité** : le traitement complet d’une facture type de 2 pages prend environ 500 ms, hors latence réseau.
- **Coût** : une facture type coûte environ 0,00049 $. On peut donc traiter environ 2 000 factures pour 1 $.
- **Scores de confiance** : chaque champ est accompagné d’un score de confiance. On peut ainsi isoler les factures qui demandent plus d’attention : une vérification manuelle, ou un passage par un LLM plus intelligent mais plus cher.
## Points faibles
**Intelligence** : Strom est un modèle de décision, il ne raisonne donc pas comme la plupart des grands LLM. Il se trompera plus souvent dans le choix des champs, surtout sur des factures qui s’éloignent beaucoup du format habituel.
**Pas de génération de texte** : par conception, les modèles de décision ne peuvent pas générer de texte. Ils ne peuvent pas, par exemple, déduire la date d’échéance de la ligne « Payable à 30 jours », alors qu’un LLM le pourrait.
## Pour conclure
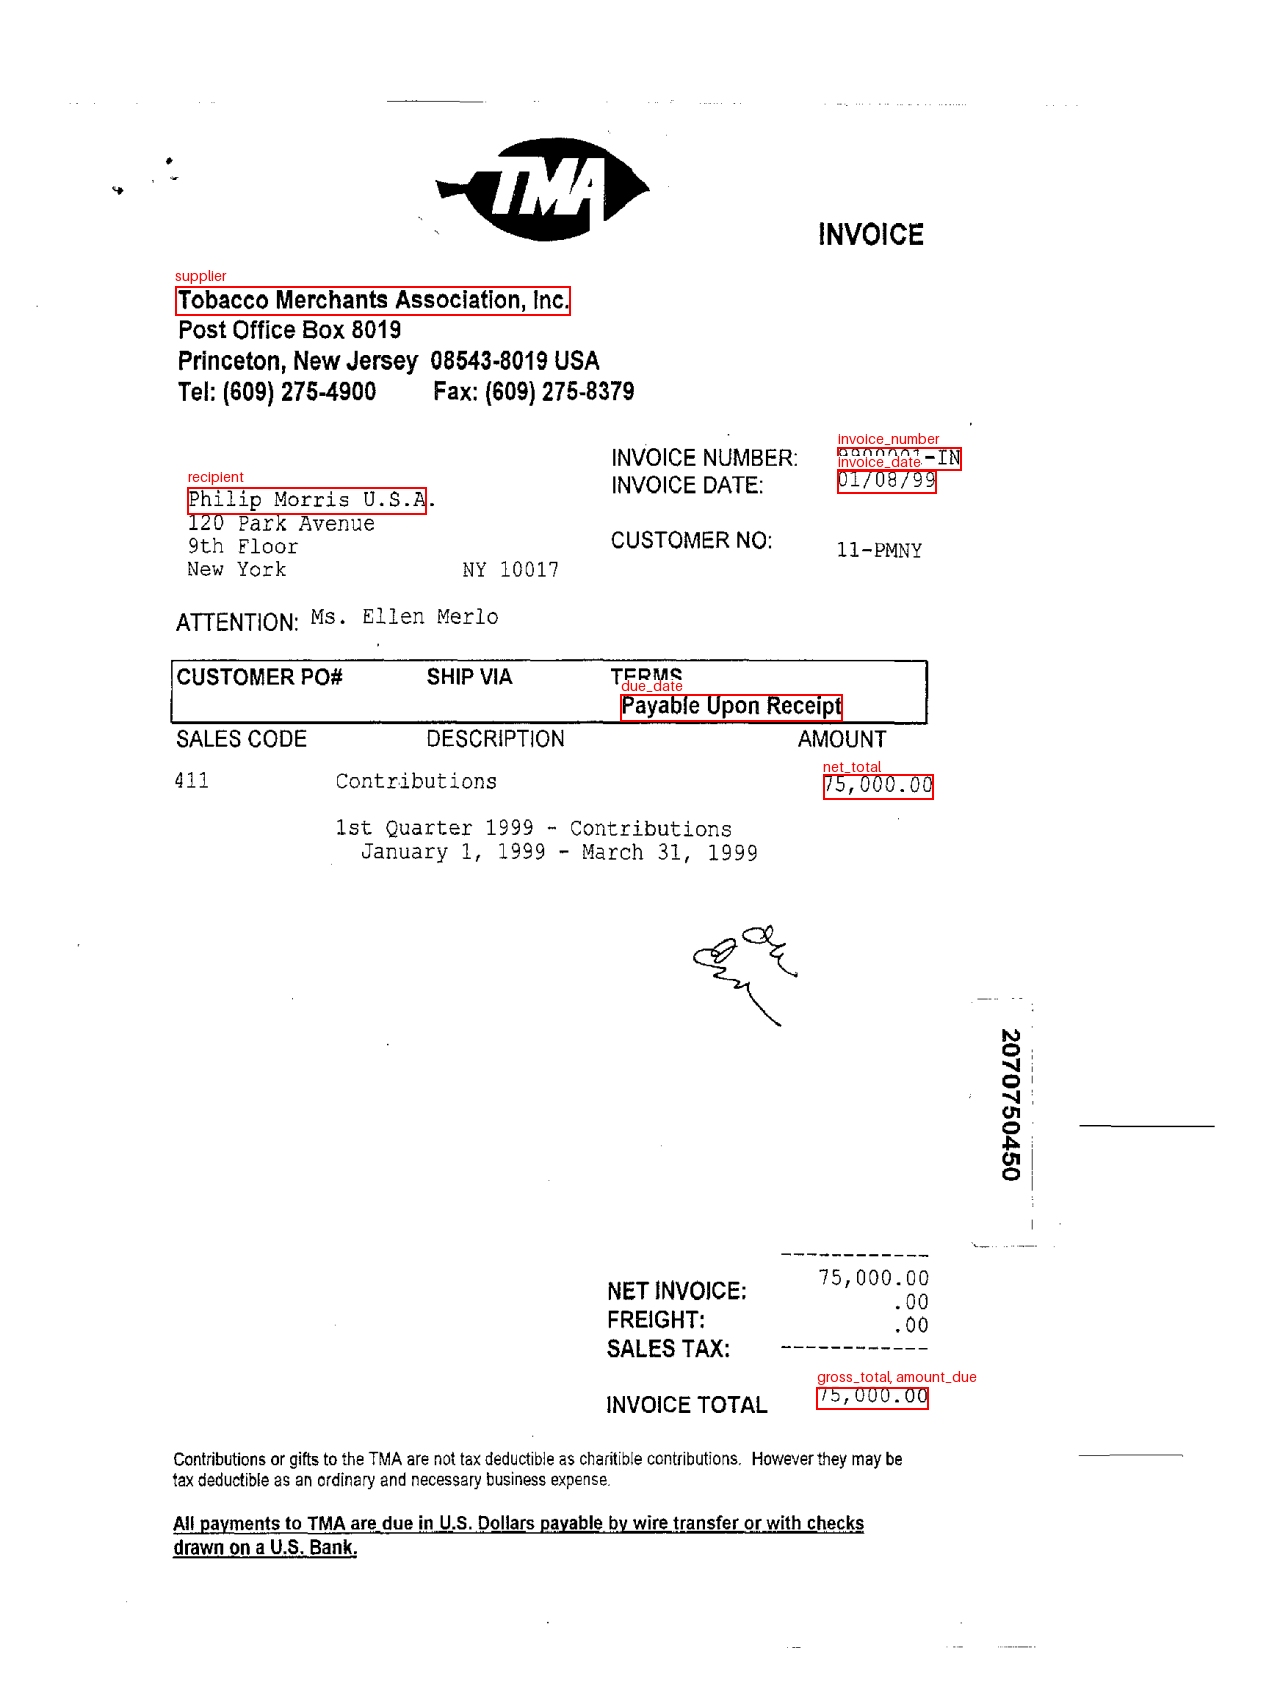
Voici ce qui revient pour la facture utilisée plus haut :
L’astuce ne se limite pas aux factures. Strom ne peut pas écrire une valeur, mais il peut en choisir une : découpez le document en candidats, numérotez-les et demandez lequel contient la réponse. Cela fonctionne de la même façon pour les contrats (quelle clause fixe le délai de préavis ?), les reçus, les formulaires ou tout autre document avec un ensemble fixe d’informations à trouver. Le modèle extrait les champs, et du code simple se charge du nettoyage et des contrôles.
Vous pouvez essayer l’analyseur de factures sur vos propres PDF ici, ou construire votre propre chaîne avec l’API.